定位:为「防污染」而设计的基准
官方对 LiveBench 的定义是「一个在设计时同时考虑测试集污染与客观评测的模型基准」。它针对的是评测领域的老问题:题目一旦公开,就可能进入下一代模型的训练数据,分数因此虚高。LiveBench 的应对办法是两条——每月发布新一批题目,且题目取材于近期发布的数据集、arXiv 论文、新闻报道与影视剧情简介,让模型很难提前「见过」。论文被 ICLR 2025 收录为 Spotlight,说明这套方法论本身也经过同行评审。
深度介绍
官方对 LiveBench 的定义是「一个在设计时同时考虑测试集污染与客观评测的模型基准」。它针对的是评测领域的老问题:题目一旦公开,就可能进入下一代模型的训练数据,分数因此虚高。LiveBench 的应对办法是两条——每月发布新一批题目,且题目取材于近期发布的数据集、arXiv 论文、新闻报道与影视剧情简介,让模型很难提前「见过」。论文被 ICLR 2025 收录为 Spotlight,说明这套方法论本身也经过同行评审。
第二个设计要点是评分方式。官方说明每道题都有可验证、客观的标准答案,因此可以用程序精确且自动地判分,不必借助模型裁判(LLM judge)。这一点对结果的可信度影响很大:模型裁判本身有偏见与波动,用它给另一个模型打分会让排名变得难以复现。LiveBench 要求模型把答案写在指定标签内以便解析,配合标准答案即可完成判分;代价是题目形式受限,不能自由发挥。
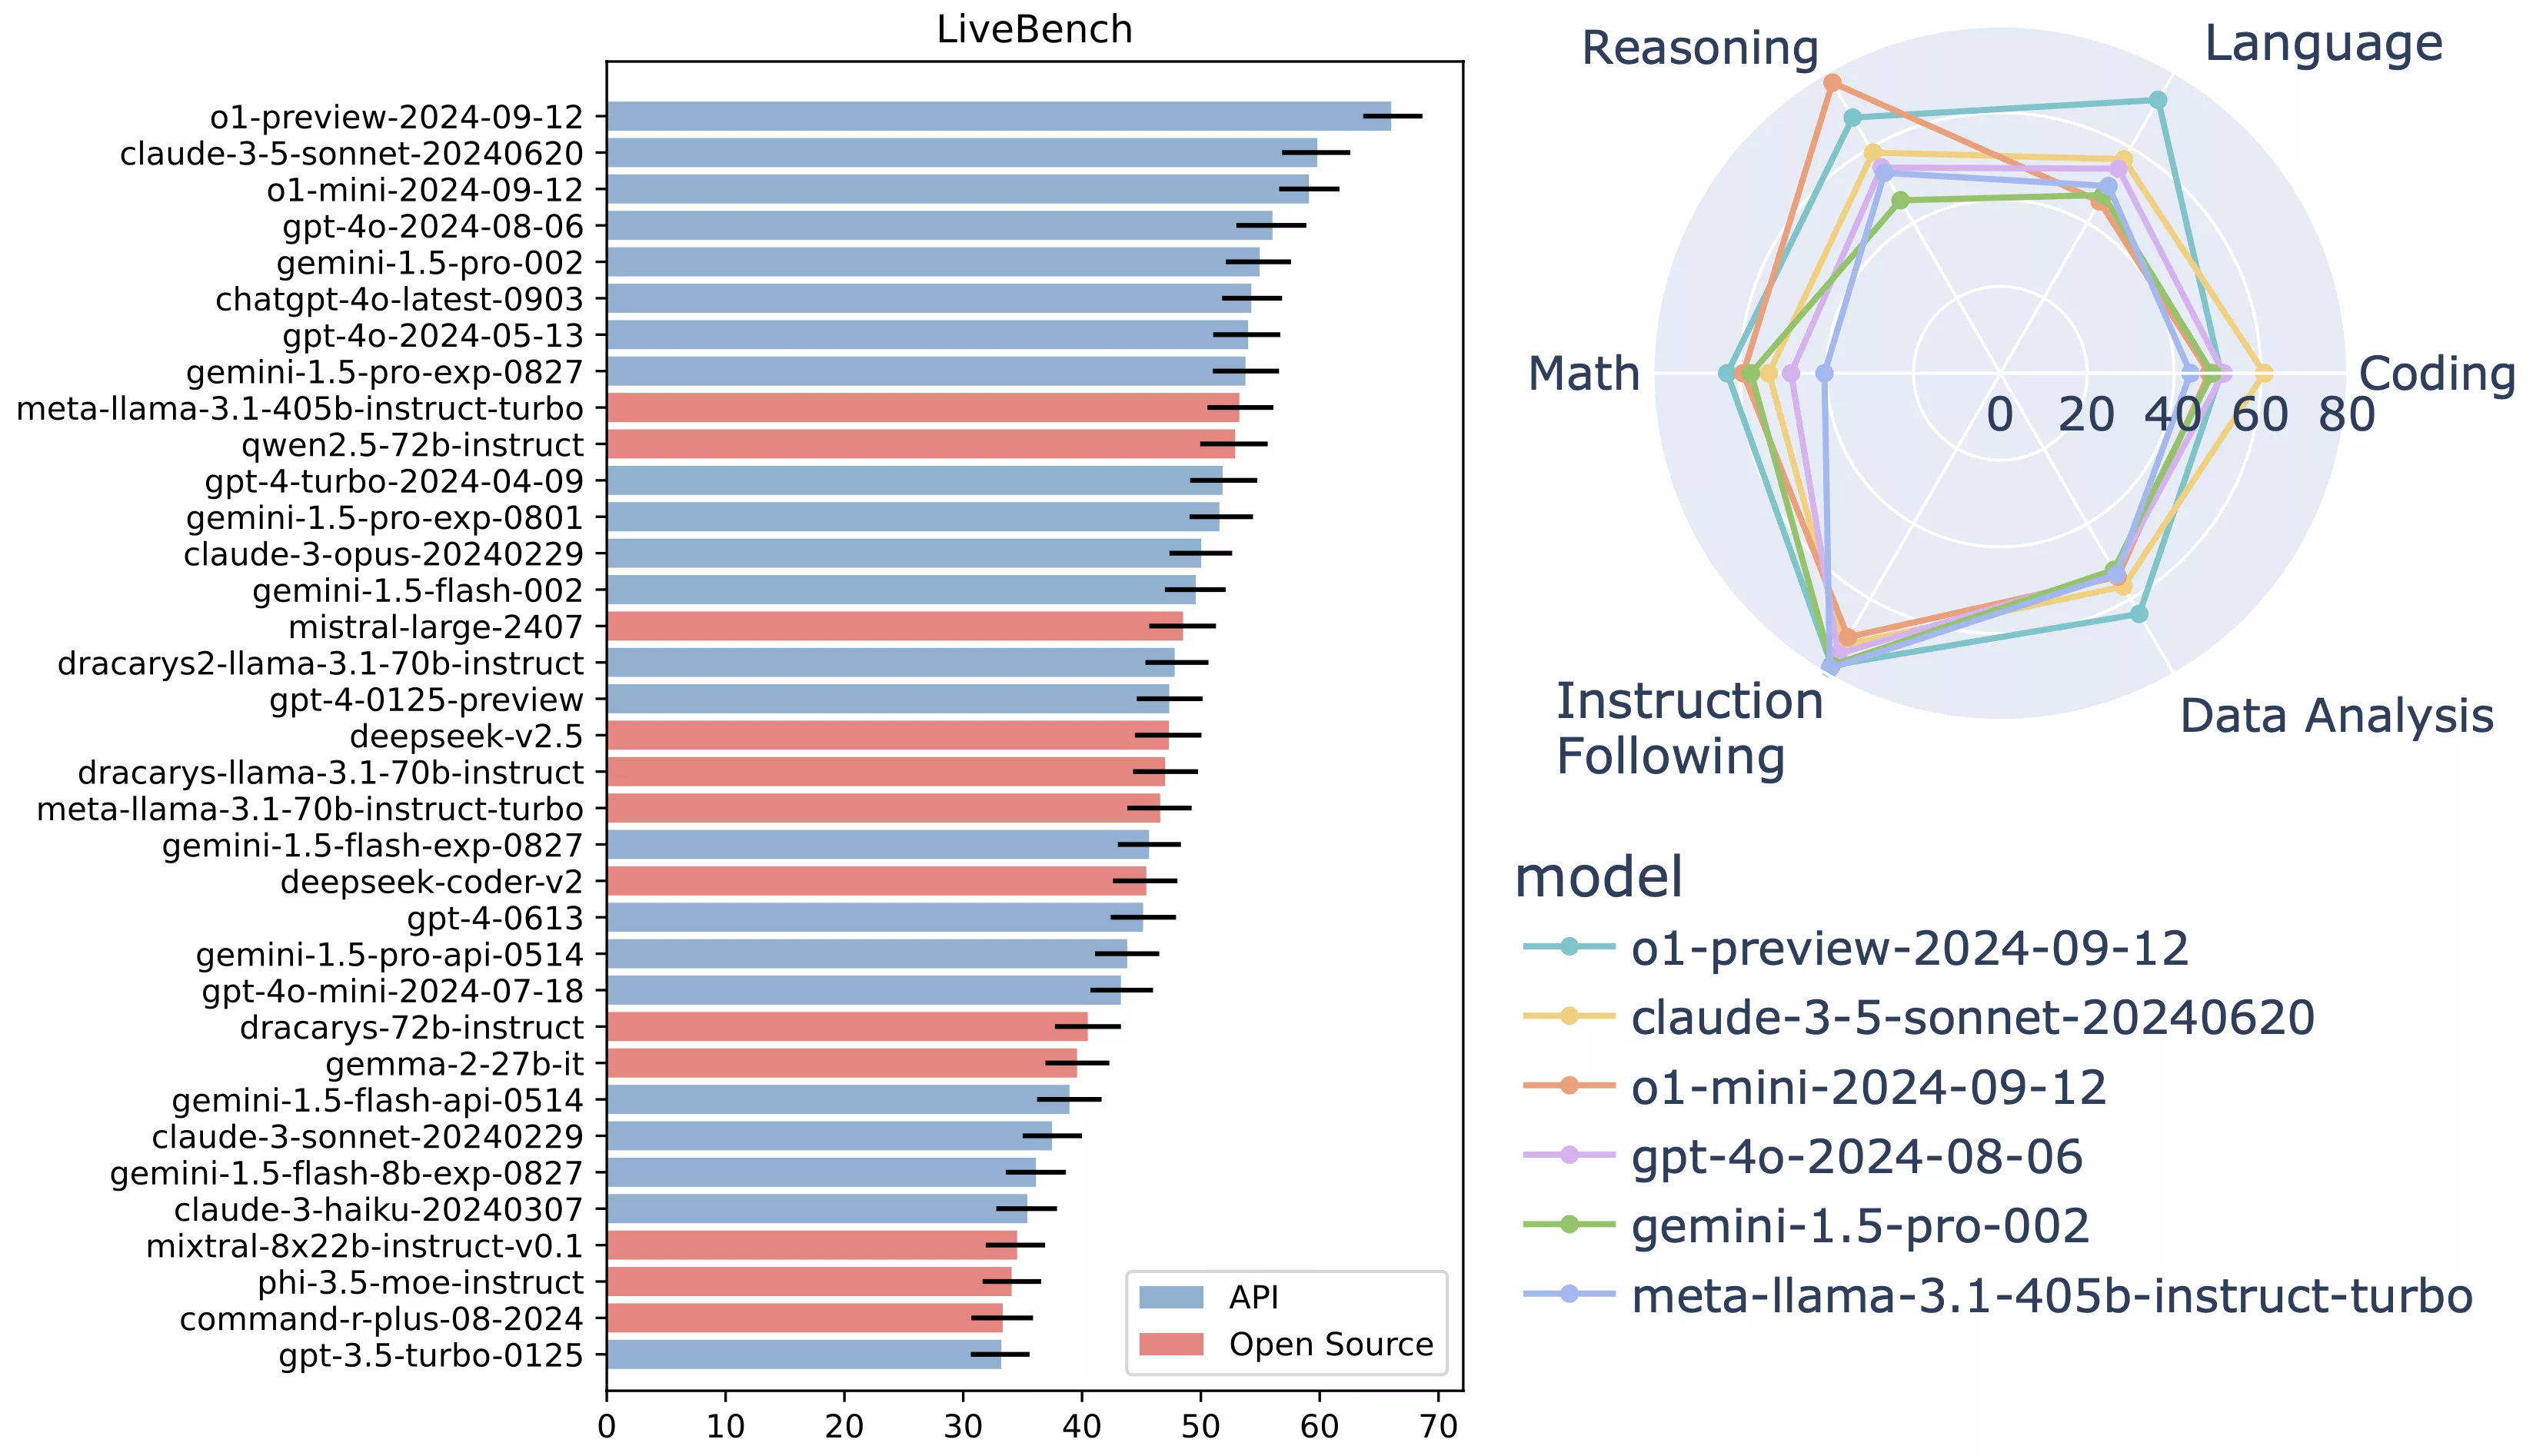
基准覆盖推理、数学、编程、语言、数据分析与指令遵循六个类别,官方 README 提到其包含 18 项不同任务,并说明会持续加入更难的题目。题目、模型答案与判定结果都按类别发布在 Hugging Face 上,包含题目、答案与判定三组数据集,任何人都可以下载核对某条分数的由来。对写论文或做内部评测的团队,这意味着可以直接复用题目集,而不必从零构造。
2025 年 5 月 30 日的更新引入了一个「智能体编程」类别:模型需要在多轮、接近真实的开发环境中修复来自真实仓库的议题,任务覆盖 Python、JavaScript 与 TypeScript,评测环节使用 Multi-SWE-Bench 的工具链。官方称这是当时最接近真实开发能力的评测方式。2025 年 10 月 3 日又把执行智能体从 SWE-Agent 换成 mini-SWE-agent,理由是设计更简单、对各模型接口更一致,同时把步数上限从 50 提高到 250,并据此重跑了全部模型、更新了榜单。
更新日志记录了多轮「刷新」动作。2025 年 11 月 25 日的更新明确写出目的是缓解基准的饱和与污染问题:更新了 connections 的题目、为 math_comp 与 olympiad 换入更新竞赛的题目、给指令遵循加入来自新文章的更难指令类型、把 zebra_puzzle 换成更难的版本,并用 theory_of_mind 取代了此前的 web_of_lies_v3。对使用者而言,这意味着历史分数与最新分数之间未必完全可比,引用时应标注榜单日期。
2025 年 12 月 23 日新增推理任务「Logic with Navigation」,要求在解出逻辑问题后再在二维空间中导航;2026 年 1 月 8 日又加入两项:数学任务「Integrals with Game」把博弈问题与积分计算结合,数据分析任务「consecutive events」考察模型检测特定事件的能力。从任务命名可以看出团队的偏好——把多个能力叠加成一道题,而不是单一技能的重复练习,这也让分数更难被针对性刷高。
项目以 Python 包形式提供,基本流程是安装后用脚本生成模型答案、执行判定,再展示结果;编程类任务需要额外安装代码运行依赖,智能体编程类任务需要本机具备 Docker,运行前会做检查。官方还提供下载脚本用于获取题目与榜单结果,并支持自行构造题目集或修改提示词来做对照实验。需要注意的是本地模型推理并不在官方维护范围内,自建模型通常要自己处理推理环节。
官方明确表示愿意评测第三方模型,可以通过提交议题或邮件联系团队;代码托管在 GitHub,许可为 Apache-2.0(许可文件说明原始文本取自另一开源项目),仓库约有 1,326 个 star。对模型作者,这条通道意味着可以把成绩加入官方榜单;对使用方,建议同时记录评测时的榜单版本与日期,因为题目会按月更新,跨月对比需要留意口径变化。
产品特点
每月发布新一批题目,并让题目取材于近期数据集、论文、新闻与影视剧情简介,降低模型提前见过题目的可能,这也是它区别于静态基准的核心设计。
每道题都有客观标准答案,判分由程序完成而不依赖模型裁判,减少评分环节引入的偏见与波动,使结果更容易复现与逐条核对,代价是题目形式受限。
2025 年 5 月新增的智能体编程类别要求模型在多轮真实开发环境中修复真实仓库议题,覆盖 Python、JavaScript 与 TypeScript,并使用 Multi-SWE-Bench 工具链判分。
六类任务的数据集连同模型答案与判定结果都发布在 Hugging Face,任何人可以复核某条分数的来源,也可以复用题目集做自建评测。
最近动态
官方更新日志显示 2026 年 1 月 8 日新增一项数学任务「Integrals with Game」,把博弈问题与积分计算结合;同时新增数据分析任务「consecutive events」,考察模型识别特定连续事件的能力。
官方更新日志显示 2025 年 12 月 23 日新增推理任务「Logic with Navigation」:模型需要先解出逻辑问题,再据此在二维空间中完成导航,属于把多种能力叠加的任务形式。
官方更新日志说明该次更新刷新了多项任务:connections 换入更新谜题,math_comp 与 olympiad 换入更新竞赛题目,指令遵循加入更难的新指令类型并修复不可完成的题目,zebra_puzzle 换成更难版本,并用 theory_of_mind 取代 web_of_lies_v3。
官方更新日志显示 2025 年 10 月 3 日把智能体编程所用的执行智能体从 SWE-Agent 换成 mini-SWE-agent,理由是设计更简单、与各模型的接口更一致;同时把步数上限从 50 提高到 250,并对全部模型重跑、更新了 2025 年 5 月 30 日的榜单结果。
LiveBench 是一个面向大模型的基准,官方把它定义为「在设计上同时考虑测试集污染与客观评测的模型基准」。它针对评测领域长期存在的两个问题给出对策:一是每月发布新一批题目,且题目取材于近期发布的数据集、arXiv 论文、新闻报道与影视剧情简介,降低模型提前见过的可能;二是每道题都有可验证的客观标准答案,判分由程序完成而不使用模型裁判,从而减少评分环节的偏见并保证结果可复现。相关论文被 ICLR 2025 收录为 Spotlight。 基准覆盖推理、数学、编程、语言、数据分析与指令遵循六大类,官方 README 提到包含 18 项不同任务并会持续加入更难的题目;题目、模型答案与判定结果都按类别发布在 Hugging Face,便于复核分数来源或复用题目集。2025 年 5 月 30 日的更新新增了「智能体编程」类别:模型需要在多轮、接近真实的开发环境中修复真实仓库的议题,覆盖 Python、JavaScript 与 TypeScript,并使用 Multi-SWE-Bench 的工具链判分;2025 年 10 月 3 日又把执行智能体换成 mini-SWE-agent,同时把步数上限从 50 提高到 250,并据此重跑全部模型、更新榜单。 项目对「刷新」相当积极:2025 年 11 月 25 日的更新明确以缓解饱和与污染为目标,换入更新竞赛题、更难指令类型与更难的 zebra_puzzle,并用 theory_of_mind 取代 web_of_lies_v3;2025 年 12 月 23 日新增推理任务「Logic with Navigation」;2026 年 1 月 8 日再新增数学任务「Integrals with Game」与数据分析任务「consecutive events」。这些动作让基准保持新鲜,但也意味着跨月的历史分数未必完全可比。 使用方面,项目以 Python 包提供,流程是安装后生成模型答案、执行判定并展示结果;编程任务需要额外的运行依赖,智能体编程类别需要本机具备 Docker。代码托管在 GitHub,许可为 Apache-2.0,仓库约有 1,326 个 star,官方也接受第三方模型的评测提交。引用具体分数时建议标注榜单日期与题目版本,因为题目按月更新且会被替换;本地模型的推理环节不在官方维护范围内,自建模型需要自行处理。
核验信息
本页事实来自 LiveBench 官方渠道:官方仓库 README(防污染与客观评测的设计目标、题目来源、六类任务与 18 项任务的说明、数据与答案判定数据集、安装与使用流程、提交模型评测的方式、Apache-2.0 许可)与更新日志(2026 年 1 月新增数学与数据分析任务、2025 年 12 月新增 Logic with Navigation、2025 年 11 月的大规模刷新、2025 年 10 月改用 mini-SWE-agent 并放宽步数、2025 年 5 月新增智能体编程类别及其语言覆盖与评测工具链),以及官网榜单、ICLR 2025 Spotlight 页面与 Hugging Face 数据集页面。信息核验于 2026 年 9 月 22 日,请以官方当期页面为准。
LiveBench介绍页面对您是否有帮助?